前言
写博客的时候为了节省服务器磁盘空间,就将图片上传到一些免费的图床里,久而久之,图片就散落到各处图床了。现在发现一些旧文里的图片都裂了,原来是以前用过的免费图床没了,图片链接自然就挂了。
图片放在别人家里,可能哪天就被锁门再也见不到了。所以我们最好把散落各处的图片统一搬进了我们自己的对象存储,自主可控、成本透明、想迁走也能随时迁走。本文就来讲一讲图片搬家这件事:怎么盘点、怎么批量下载以及怎么替换文章里的旧外链,希望对大家有所帮助。
为什么外链图床靠不住
先说微博图床这个经典案例。前些年它陆续对站外引用加了防盗链限制——图片本身还在,但你在自己博客里引用的链接,一夜间全部变成裂图。多少个人博客一夜之间变回了"文字站"。不过这也不好怪它,毕竟人家图床本来就是给自家产品用的,只是我们一直把它当免费仓库。
同样的故事在各处上演:免费图床站宣布关闭、限速、甚至可能被黑客劫持……每一项对我们的外链都是致命的。
图片上传到本地呢?也好不到哪去:
占VPS磁盘,图片越攒越多,小机器空间吃紧
备份要跟整站一起走,恢复麻烦
换服务器的时候,几个GB的图片目录跟着迁移,慢且容易漏
而对象存储这几条全占优势:按量付费花不了几个钱、对象存储独立于服务器存在、搬家就是复制粘贴。至于对象存储怎么选型,可以参考本站文章《如何根据自己的需求选型对象存储?》。
搬家前先盘点
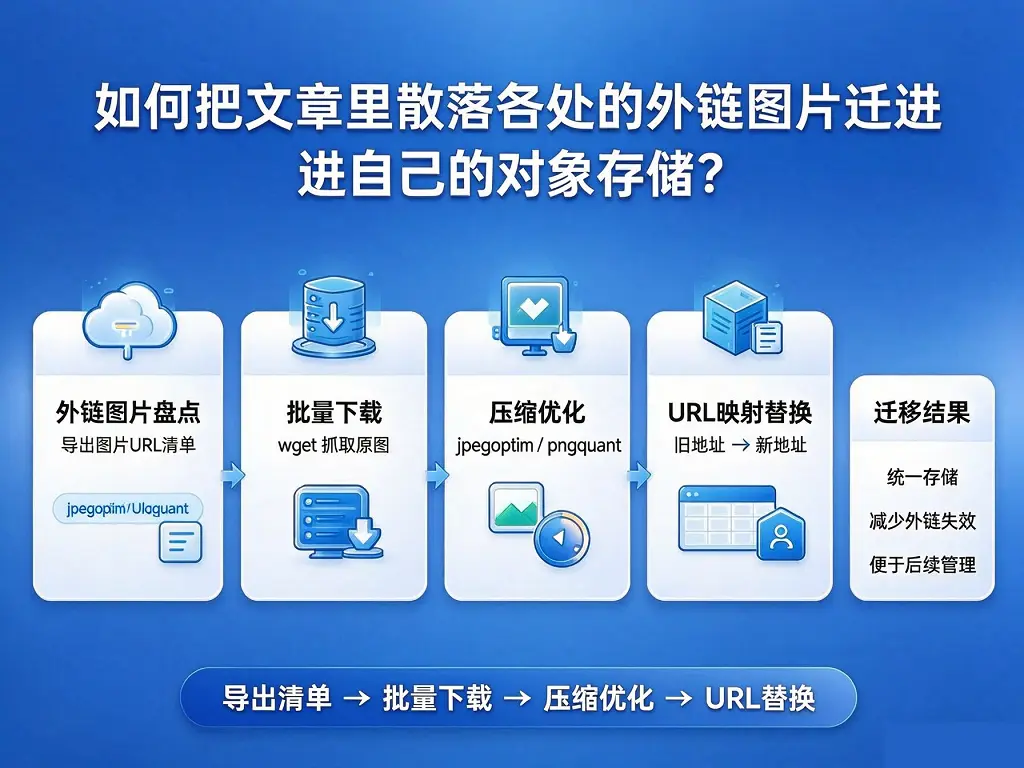
搬家最忌讳的是想到哪搬到哪,搬到一半发现漏了一批。先把自己的家底摸清楚。
第一步:找出所有引用了外链图片的文章。
如果博客是WordPress,图片外链都在数据库的文章内容里,用SQL先定位范围:
SELECT ID, post_title FROM wp_posts WHERE post_content LIKE '%sinaimg%'; 把sinaimg换成你要排查的图床域名,表名wp_posts在你的数据库里前缀wp可能是别的,最好先show tables;看看,哪些文章引用了外链一目了然。
第二步:把外链URL去重后存成清单文件。
光知道哪几篇文章还不够,操作上要的是一份纯粹的URL清单。WordPress站接着上面用WP-CLI把文章内容导出来,再提取图片链接:
wp db query "SELECT post_content FROM wp_posts WHERE post_content LIKE '%sinaimg%'" --skip-column-names > posts.txt

grep -oE 'https?://[^\"() ]+\.(jpg|jpeg|png|gif|webp)' posts.txt | sort -u > urls.txt
第一条命令把所有命中文章的正文内容原样导出到posts.txt,第二条从里面把图片链接整条抠出来、去重、存进urls.txt。
静态站更简单,直接在源码目录里全局搜:
grep -rEo 'https?://[^ "]+\.(jpg|png|gif|webp)' ./content/ | sort -u > urls.txt 跑完可以打开urls.txt对一眼,长这样就是对的:
https://wx1.sinaimg.cn/large/005KdJQ2ly1gt8abc123.jpg
https://wx2.sinaimg.cn/mw690/005KdJQ2ly1gu9def456.png
https://wx3.sinaimg.cn/large/005KdJQ2ly1gs0ghi789.gif
https://i.oldfreehost.com/uploads/2023/cover.webp
一条一行、全部去重,后面下载和替换全靠这份清单驱动。本地uploads目录里的图片不在清单里也不要紧,它们本来就是你的,搬家时一起传上去就行。
批量下载
清单有了,开始动手。这里推荐用显式指定文件名的方式下载:
while read -r url; do
wget -O "./images/$(basename "$url")" --referer=https://weibo.com/ "$url"
done < urls.txt -O直接指定保存路径,basename取URL尾部的文件名——也就是把本地文件名强制钉成外链URL里的那个哈希名(比如005KdJQ2ly1gt8abc123.jpg)。
取URL尾部的文件名这一步不能省。因为下载到本地的文件名存在两种可能:
用
wget -i批量下、或者wget/curl这类工具默认按URL尾部名保存,得到的是哈希名;如果走浏览器右键另存、或者服务器在响应里返回了"原始文件名",落到本地的就是你当初上传时的名字(比如
123.jpg)。
原始名有两个坑:
它和外链URL对不上,后面"靠推导关系做外链替换"的路线就断了;
原始名极其容易撞车,如果不同文章的两张图都叫
IMG_0001.jpg,下载时一张就把另一张覆盖了。
所以干脆在入口处用-O把名字钉死:本地文件名=URL尾部的哈希名,一对一,谁也不覆盖谁。
微博图床这类带防盗链的源,直接下会被拦,带上--referer伪装成站内请求基本就能下动。如果换了别的图床源下不动,同样思路,把它家站点域名填进referer试试。
下载完先压缩一遍
既然要把几百张图传进对象存储,建议上传前先批量压缩,毕竟存储费按体积走、流量费按下行走,图片瘦一圈,账单就跟着瘦一圈,而且读者那头的观感几乎不受影响。
命令行两个老工具就够:
# JPG:限制最高质量85,原地压缩
find ./images -name '*.jpg' -exec jpegoptim -m85 {} \;

# PNG:量化压缩,原地覆盖
find ./images -name '*.png' -exec pngquant --quality=70-90 --force --ext .png {} \;
jpegoptim -m85是把JPG质量上限压到85,肉眼基本看不出差别,体积通常能砍掉三到四成;pngquant是PNG专用的有损量化,--force --ext .png保证压完还是原文件名。博客文章里的配图大多本来就是屏幕尺寸,不涉及打印级精度,这个压缩力度读者是感知不到的。
想要更狠的,可以转WebP格式,体积再省四分之一以上,但是要注意:转换会生成.webp新文件名,等于动了文件名,后面替换链接时要按新名字对应,走下面的映射表路线。图省事的话,原地压缩JPG和PNG就已经够用了。
顺带一提,如果WordPress博客的图片都在本地媒体库里,EWWW Image Optimizer这类插件能在后台批量压缩。
规划目录和文件名
上传之前,想清楚桶里的目录结构和你给文件起名的规则。这里有个直接决定后面替换环节简单还是复杂的选择:
路线A:不改名,只进统一目录(推荐)。 微博图床的文件名虽然是哈希乱码,但它不重复——直接沿用这个哈希名称,全部放进/images/一个目录。你盘点清单时看着乱没关系,反正文章引用靠的是URL,正常显示没问题。本地uploads的图片同理,保留原目录结构传上去。
路线B:重命名,走可预测的规则。 实在想要语义化文件名,让改名规则保持"纯加前缀"这种机械模式,比如统一加日期前缀:
cd ./images
for f in *; do mv "$f" "2024-$f"; done
一条循环批量改完,不用一个一个来。前缀是固定的、原文件名没丢,这样"旧URL→新URL"的对应关系依然是可推导的。
路线C:起全新的目录和语义化名字(比如24号文章/nginx端口排查-配图1.jpg)。 目录规整,名字清晰,但旧名和新名之间没有任何机械对应关系了,因此这条路必须自己维护一份"旧URL→新URL"映射表,替换时逐条精确替换,后面会讲怎么操作。
还有个细节要提:如果后续图床前面要挂CDN,文件名带版本号(比如2024-cover-v2.jpg)会方便很多——CDN缓存和客户端缓存都以URL为单位,改内容不改名字,旧缓存会一直赖着不走,这个在本站文章《图床的防盗链、缓存和清理怎么做?》里讲过。所以路线B的前缀除了日期,也可以顺手带上版本。
上传对象存储
为什么我们要用对象存储,而不是搬去另一家图床?
一是因为对象存储完全由我们自己自主。
二是对象存储可以不重新命名。你传上去的目录和文件名是什么,访问URL的路径部分就是什么——传Article15/sql查询语句.jpg,URL就是.../Article15/sql查询语句.jpg,一字不差。而微博、imgur这类图床服务会在你上传后重新生成一串哈希文件名,各家生成规则还互不相同(有的掺用户ID和时间戳、有的取文件内容哈希、有的纯随机),同一张图传到不同图床后的名字完全不同,甚至重传同一家都可能会变。一旦新图床重新给图片起了名,旧URL→新URL的推导关系就断了,就只能一张一张的建立映射表来替换。对象存储把命名权留给你,这才有前面"一条命令搞定替换"的底气。
本地文件收拾干净了,用rclone上传:
rclone copy ./images/ remote:bucket/images/ --transfers 8 --transfers 8是8个并发,几百张图的量级,一杯茶的功夫就传完了。还没配置过rclone的,可以参考本站文章《通过对象存储做定时备份与异地容灾》。
顺带一提存储成本这件事:以我实际在用的VMRack对象存储为例,每月免费送5GB存储加10GB下行——按一张压缩图200KB算,5GB能放两万多张,个人博客的图片存量基本够用很久了。
批量替换文章里的外链
图片搬好了,最后一步是把文章里的旧链接换成新地址。这一步最危险:替换错了,图和文章就对不上号了。
我们执行批量替换,之所以能够保证"图片正确对应文章",靠的是旧URL和新URL之间有明确的推导关系:
走了路线A(不改名):新URL = 新域名+统一目录+原文件名。旧新两个链接只差域名和目录前缀,一条域名级替换命令下去,每张图必然落在自己的位置上,不可能错位。
走了路线B(加前缀改名):新URL = 新域名+统一目录+前缀+原文件名。同样可推导,只是替换命令里把前缀带上。
WordPress站,用WP-CLI一条命令(以路线A为例):
wp search-replace 'https://wx1.sinaimg.cn/large' 'https://你的图床域名/images' --all-tables --dry-run wp search-replace比直接改数据库安全得多——它懂PHP序列化数据,不会把文章数据改坏。注意先把--dry-run带上跑一遍,它只报告会替换多少处、不动数据;确认数量对得上urls.txt里的清单规模,去掉这个参数再实跑。微博有wx1到wx4好几个子域名的话,每个域名各跑一遍。
静态站,用sed全局替换:
grep -rl 'sinaimg' ./ | xargs sed -i 's|https://wx1.sinaimg.cn/large|https://你的图床域名/images|g' 先grep -rl列出所有包含旧域名的文件,再交给sed逐个替换。用竖线做分隔符是为了避开URL里的斜杠转义问题。
走了路线C(语义化改名):没有推导关系可用了,域名级替换在这里就是错位事故——必须用映射表逐条精确替换。把urls.txt加工成一行一条的替换规则:
s|https://wx1.sinaimg.cn/large/005KdJQ2ly1gt8abc123.jpg|https://你的图床域名/images/nginx端口排查-配图1.jpg|g
s|https://wx2.sinaimg.cn/mw690/005KdJQ2ly1gu9def456.png|https://你的图床域名/images/搬家流程-示意图.png|g 存成replace.sed,静态站直接sed -i -f replace.sed 文章文件批量跑;WordPress站每行跑一次wp search-replace 旧URL 新URL。几百张图是几百行,笨是笨了点,但每一行的对应关系都是你亲手核过的,不会错。
不管用哪种方式,动手前先备份数据库和源码目录。这是铁律,不用犹豫。
搬完别急着删旧的
替换完成、检查完没有裂图,也别急着把旧图床的图片删掉。建议留一个月的双链并行期:
旧图片原地保留,不动
用浏览器开发者工具的网络面板,筛选Img请求,翻几篇旧文看看有没有漏网的404
确认新地址全部正常后,再清理旧文件
万一中间发现有文章漏替换了,旧图还在就是兜底;删早了就真没了。另外,上传到对象存储的这批文件,如果开启了版本控制,误删误覆盖都有后悔药可吃,可以参考本站文章《对象存储的版本控制是什么?误删的文件怎么找回》,搬家的节骨眼上,多一层保险总归是好的。
总结
图床搬家这件事,本质是把"放在别人家里的图片"收回到自己可控的存储上。流程就六步:
盘点清单
批量下载
压缩瘦身
规划目录与命名
rclone上传
替换外链,最后留一段双链并行期兜底。
工具上没有黑科技,SQL、grep、wget、jpegoptim、pngquant、rclone、WP-CLI,全是老朋友。真正决定搬家成败的是顺序和耐心。花一个下午,把散落各处的图片收拢进自己的对象存储,以后不管那些图床怎么变脸、服务器怎么迁移,图片这块资产都稳稳在自己的手里。